
Entity Resolution & Deduplizierung in Frankfurt
Entity Resolution erkennt Datensätze, die dasselbe Unternehmen, denselben Kontakt oder ein anderes Objekt in verschiedenen Quellen beschreiben. Die Dublettenbereinigung behandelt wiederholte Datensätze innerhalb eines Bestands und entscheidet, welche Einträge zusammengehören. Für Teams in Frankfurt und Rhein-Main wird der Abgleich nützlich, wenn Kundenlisten, Lieferantendaten oder übernommene Datenbestände sich überschneiden.
Ein Abgleich vergleicht Kennungen und beschreibende Felder, bevor zusammengehörigen Datensätzen eine gemeinsame Identität vorgeschlagen wird. Ähnliche Namen allein können Fehler verursachen, besonders wenn unterschiedliche Organisationen Adressen oder gebräuchliche Abkürzungen teilen. Ein brauchbares Ergebnis erhält die Quellenbelege und trennt sichere Treffer von Fällen, die eine menschliche Prüfung benötigen.
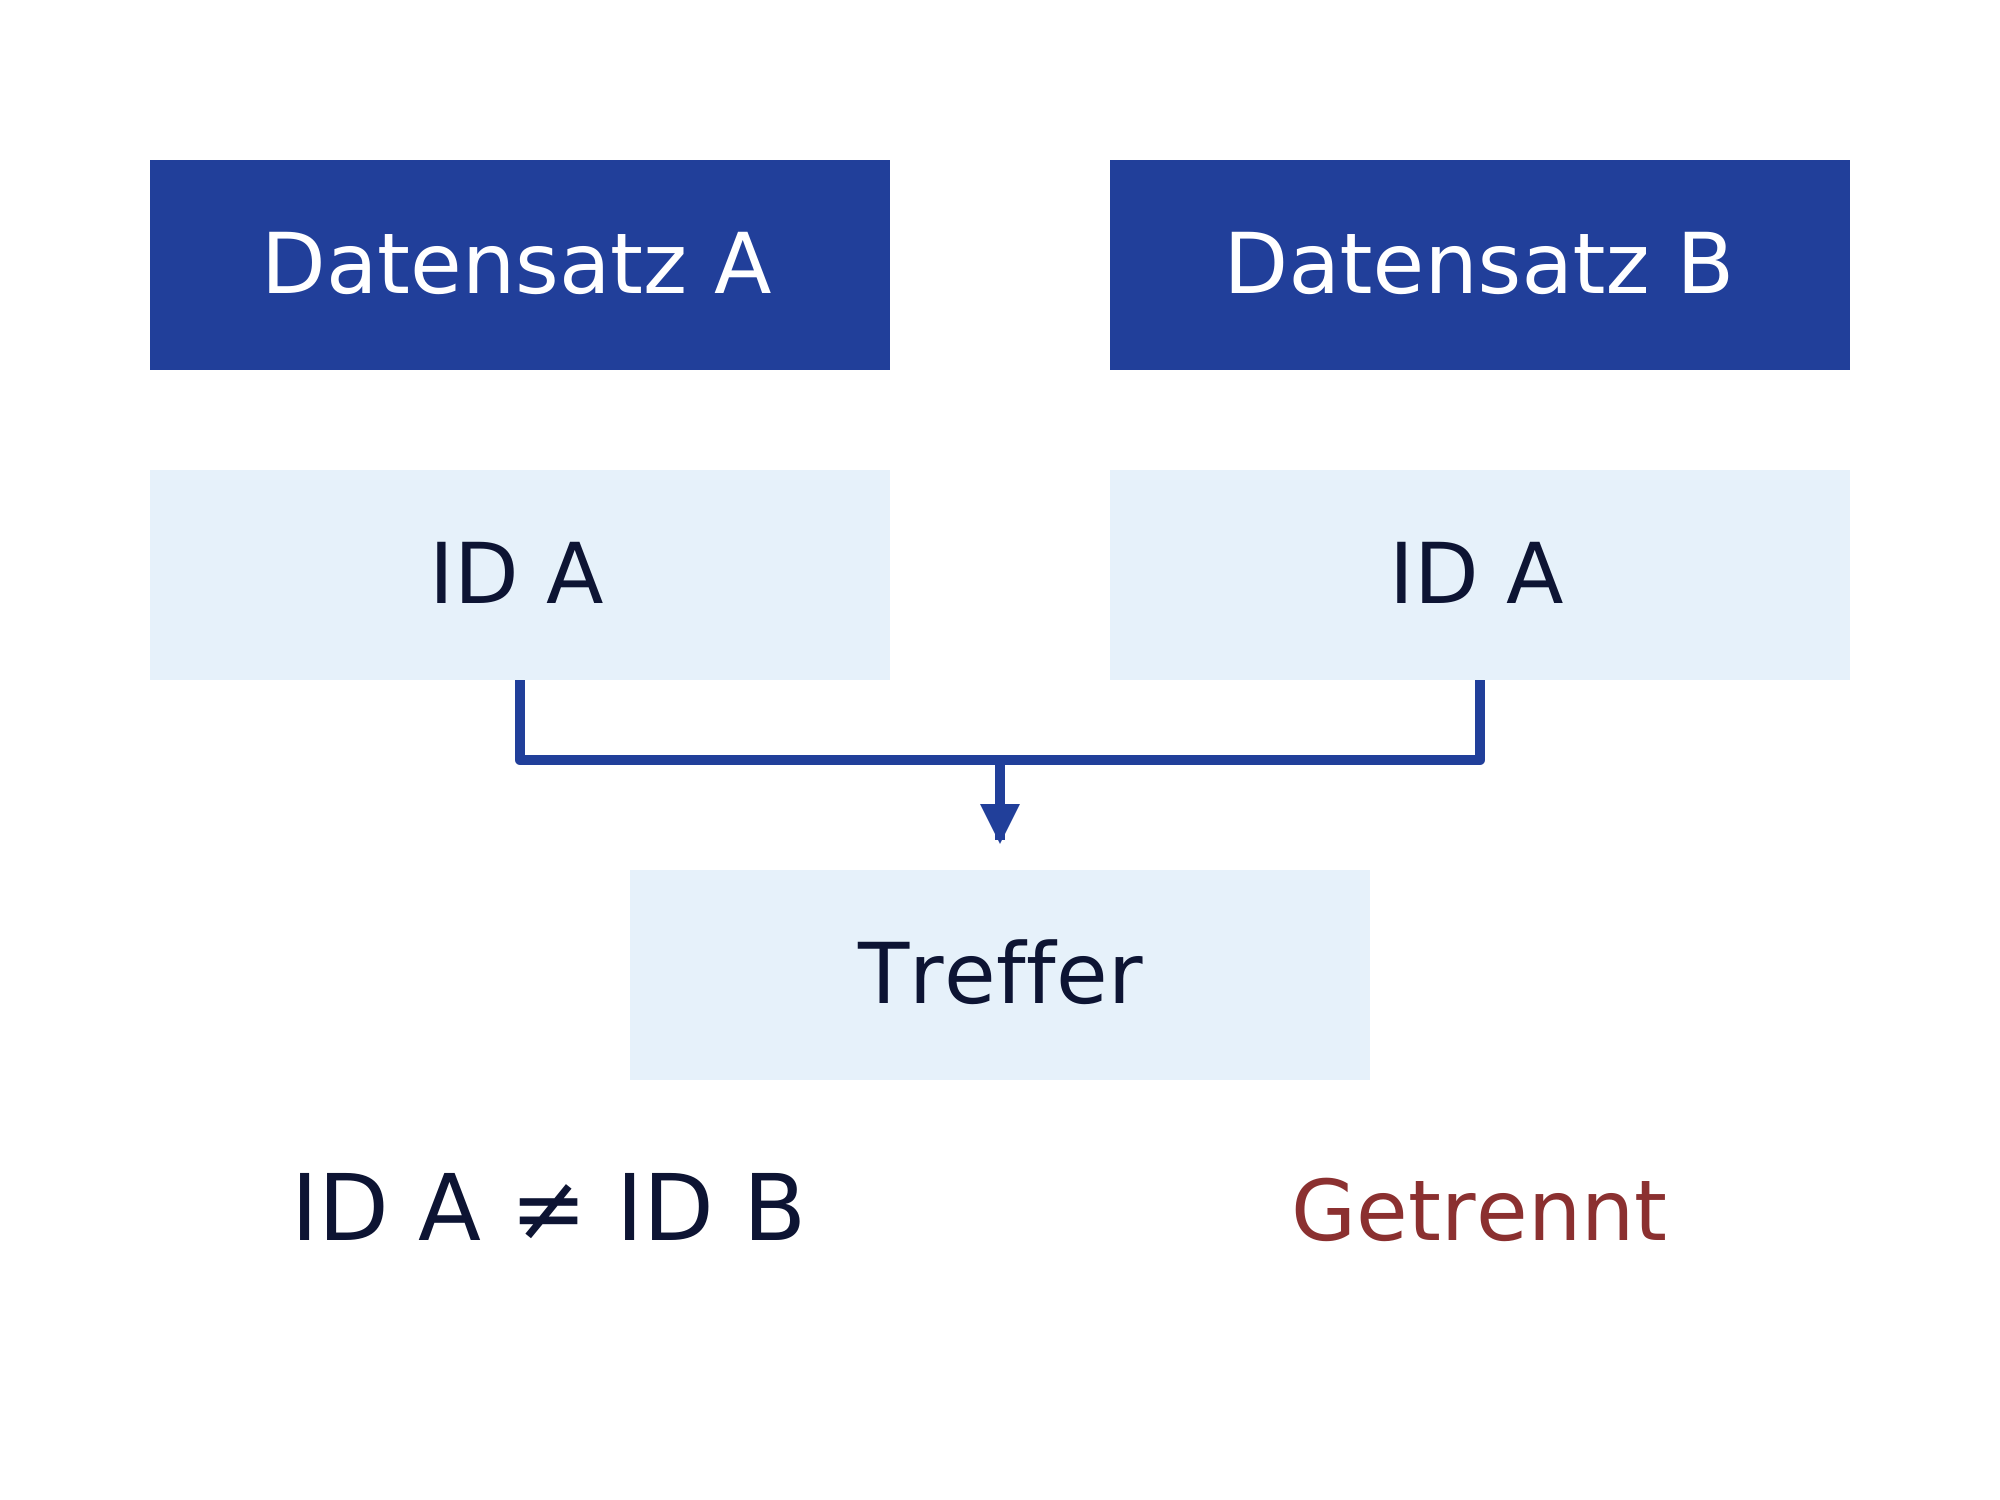
Von Quelldatensätzen zu möglichen Treffern
Definieren Sie zunächst das Objekt und die Felder, die einzelne Datensätze voneinander unterscheiden können. Unternehmensdaten und Kontaktdaten benötigen unterschiedliche Abgleichregeln, selbst wenn beide eine Adresse enthalten. Bewahren Sie Originalwerte auf, während Sie vergleichbare Fassungen von Namen, Adressen und Kennungen vorbereiten.
Exakte Regeln können verlässliche Kennungen vergleichen, während ungefähre Vergleiche Schreibvarianten oder fehlende Angaben berücksichtigen können. Eine Kandidatenauswahl begrenzt die Vergleiche, bevor eine genauere Bewertung stattfindet. Die Splink-Dokumentation beschreibt den probabilistischen Datensatzabgleich ohne eindeutige Kennungen, einschließlich Verfahren zur Bewertung der Abgleichergebnisse.
Treffer vor der Zusammenführung prüfen
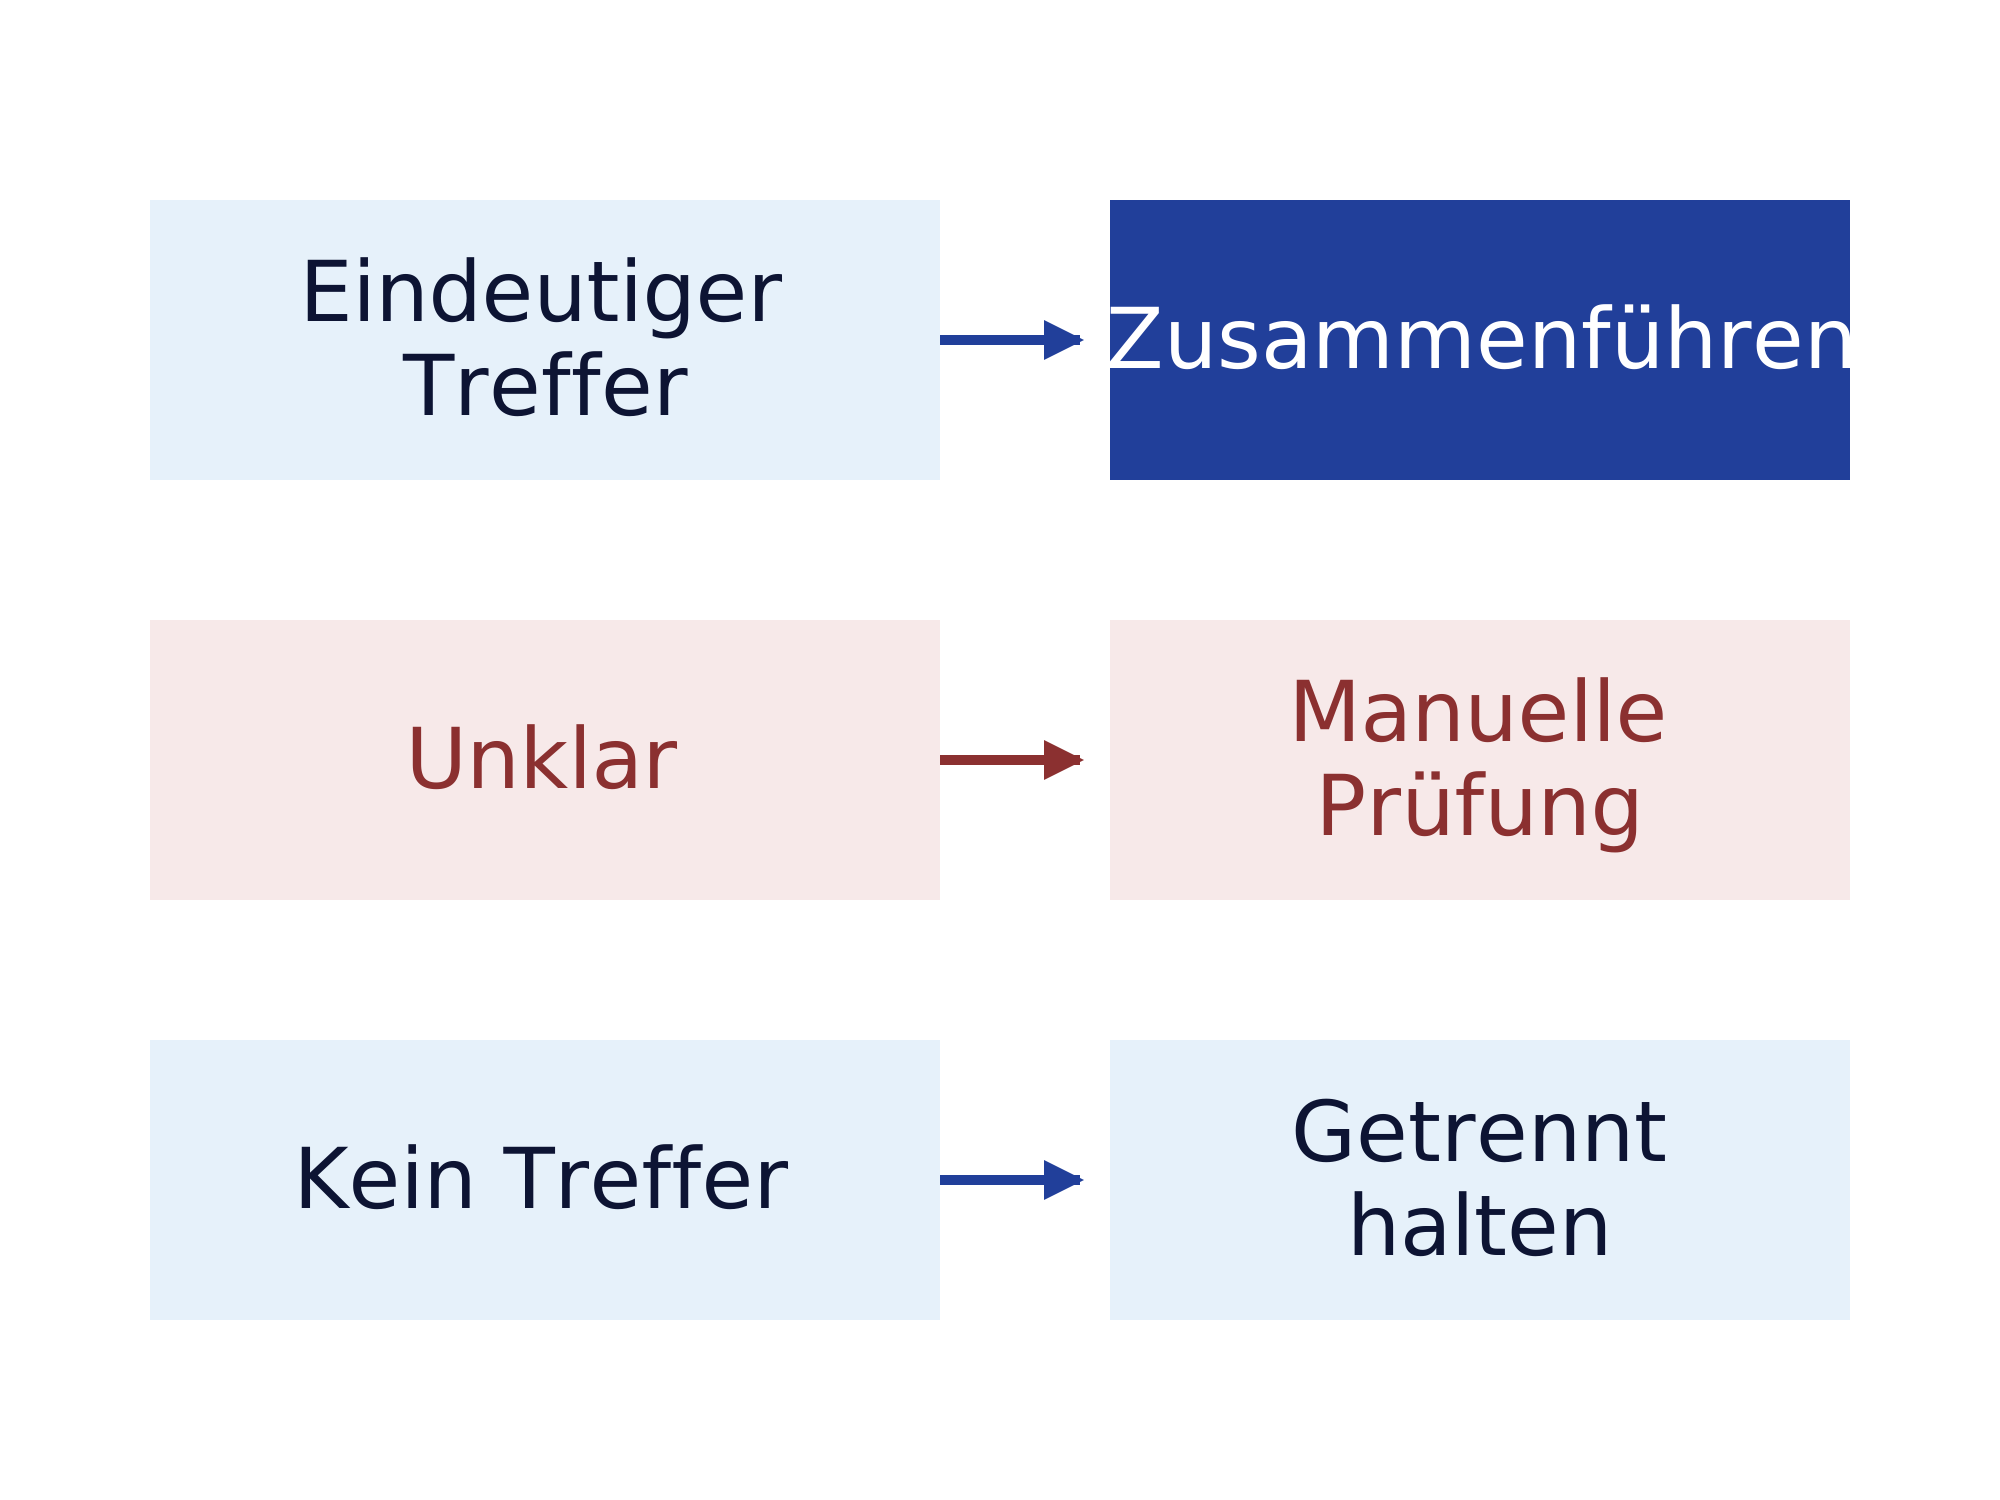
Ein Trefferwert unterstützt eine Entscheidung, stellt aber für sich genommen keine Identität fest. Definieren Sie, welche Belege einen automatischen Vorschlag erlauben und welche Kombinationen eine Prüfung erfordern. Zwei Unternehmen mit ähnlichen Namen müssen getrennt bleiben, wenn stärkere Belege einem Treffer widersprechen.
Vereinbaren Sie, welche Quelle jedes übernommene Feld liefert und wie widersprüchliche Werte sichtbar bleiben. Erhalten Sie die ursprünglichen Datensatzkennungen, die Abgleichregel und die Prüfentscheidung zusammen mit der entstandenen Zuordnung. Eine gemeinsame Identität kann Datensätze verbinden, ohne sofort sämtliche Quelleinträge zu löschen oder zu überschreiben.
Abnahmekriterien für die Dublettenerkennung
Erstellen Sie eine Referenzstichprobe mit echten Dubletten, unabhängigen Datensätzen mit ähnlichen Namen und unvollständigen Einträgen. Prüfen Sie falsche Treffer getrennt von übersehenen Dubletten, weil die Folgen erheblich voneinander abweichen können. Die alleinige Wiederverwendung der Trainingsbeispiele zeigt nicht, wie der Abgleich bei unbekannten Datensätzen funktioniert.
Lassen Sie den Anbieter strittige Treffer vorführen und die Belege hinter jeder Entscheidung erklären. Vereinbaren Sie Abnahmekriterien für die relevanten Datensatztypen, bevor die Regeln auf den Gesamtbestand angewendet werden. Die Übergabe sollte festhalten, wer neue Unklarheiten prüft und wer frühere Zuordnungen korrigieren darf.
Projektplanung in Frankfurt und Rhein-Main
Ein regionales Projekt beginnt mit den beteiligten Systemen, Datenverantwortlichen und Zuständigkeiten für die Prüfung. Bringen Sie eine zulässige Stichprobe, Beispiele schwieriger Dubletten und den geplanten Verwendungszweck zum Erstgespräch mit. Vereinbaren Sie, ob Workshops einen Vor-Ort-Termin erfordern oder mit den zuständigen Teams remote stattfinden können.
Das Angebot sollte erste Datenanalyse, Abgleichregeln, menschliche Prüfung, Integration und spätere Pflege unterscheiden. Der Prüfaufwand hängt von Anzahl und Mehrdeutigkeit möglicher Treffer ab, nicht allein von der Gesamtzahl der Datensätze. Zugangsregelungen und Zuständigkeiten für Korrekturen gehören neben den technischen Ergebnissen in den Projektumfang.
Filialen beim Datensatzabgleich in Rhein-Main unterscheiden
Beschreiben Kundendaten Filialen in Frankfurt und Darmstadt unter demselben Unternehmensnamen, definieren Sie, ob das Ergebnis das Unternehmen oder jede Filiale identifizieren soll. Ein gemeinsamer Name kann eine Unternehmensbeziehung begründen, während getrennte Lieferadressen für die tägliche Arbeit nötig bleiben. Nehmen Sie beide Filialen und einen tatsächlich doppelten Filialdatensatz in die Referenzstichprobe auf. Prüfen Sie die vorgeschlagene Beziehung vor Änderungen an Kennungen, die ein anderes Team für Aufträge, Einsätze oder Kundenkorrespondenz verwendet.
Gateflow als Anbieter
Gateflow ist ein Frankfurter IT-Unternehmen und bietet Entity Resolution sowie Dublettenbereinigung in Projekten für Wissensextraktion und Datenqualität an. Gateflow vergleicht Unternehmens- oder Kontaktdaten anhand ausgewählter Kennungen und Merkmale und trennt unklare Treffer zur Prüfung ab. Gateflow erhält bei Zusammenführungen die Quellenlinks und die Angaben zur Freigabe.
Die Datenqualitätsleistung von Gateflow beginnt mit Beispieldatensätzen und vereinbarten Kontrollen vor der breiteren Verarbeitung. Besprechen Sie Abgleichregeln, Prüfwarteschlange und Betriebszuständigkeiten für Ihr Projekt in Frankfurt, Rhein-Main oder ganz Deutschland.
Verifiziert Entity Resolution eine rechtliche Identität?
Ein Datensatzabgleich stellt eine vorgeschlagene Beziehung zwischen Einträgen her, anstatt eine rechtliche Identität unabhängig zu verifizieren. Die erforderlichen Belege hängen vom geschäftlichen Zweck und den verfügbaren Quellen ab. Ein Ergebnis der Dublettenerkennung benötigt deshalb eine gesonderte Bewertung, bevor es eine Identitätsprüfung oder Compliance-Entscheidung unterstützt.
Sollte jede Dublette aus der Quelle gelöscht werden?
Quelldatensätze müssen möglicherweise für die Betriebshistorie oder spätere Korrekturen verfügbar bleiben. Vereinbaren Sie, ob das Ergebnis Datensätze verknüpft, übernommene Werte auswählt oder ursprüngliche Systeme verändert. Testen Sie, wie eine falsche Zusammenführung geprüft und korrigiert werden kann, bevor Änderungen an produktiven Datensätzen freigegeben werden.
Datenkompetenz und Finance Loop
Finance Loop verbindet Fachleute, die an neuen Technologien und deren praktischem Einsatz im Finanzwesen arbeiten. Gateflow beteiligt sich über Michael Wutzke, der in der Claude Hacker House-Reihe unterrichtet, an diesem Austausch, wobei die Besetzung je Termin variiert.
Finance Loop ist ein Experten-Netzwerk, das die institutionelle Nutzung neuer Technologien im Finanzwesen voranbringt. Finance Loop hilft Mitgliedern, Kompetenzen und berufliche Kontakte in diesen Bereichen aufzubauen: Investment & digitale Vermögenswerte, Zahlungsverkehr & digitales Geld, Digitale Infrastruktur & Souveränität und Risiko & Compliance.
Kontaktieren Sie Finance Loop für passende Fachkompetenz, praxisnahen Austausch und Verbindungen für Ihr Datenprojekt.